Evolutionary Scale เมื่อเอไอเริ่มอ่านและเขียนภาษาของชีวิต (1)
Biology Beyond Nature | ภาคภูมิ ทรัพย์สุนทร
จากห้องสมุดพันธุกรรมสู่ห้องวิจัยของ Facebook
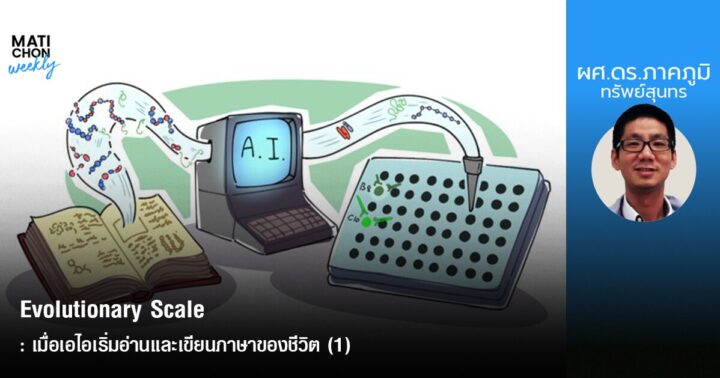
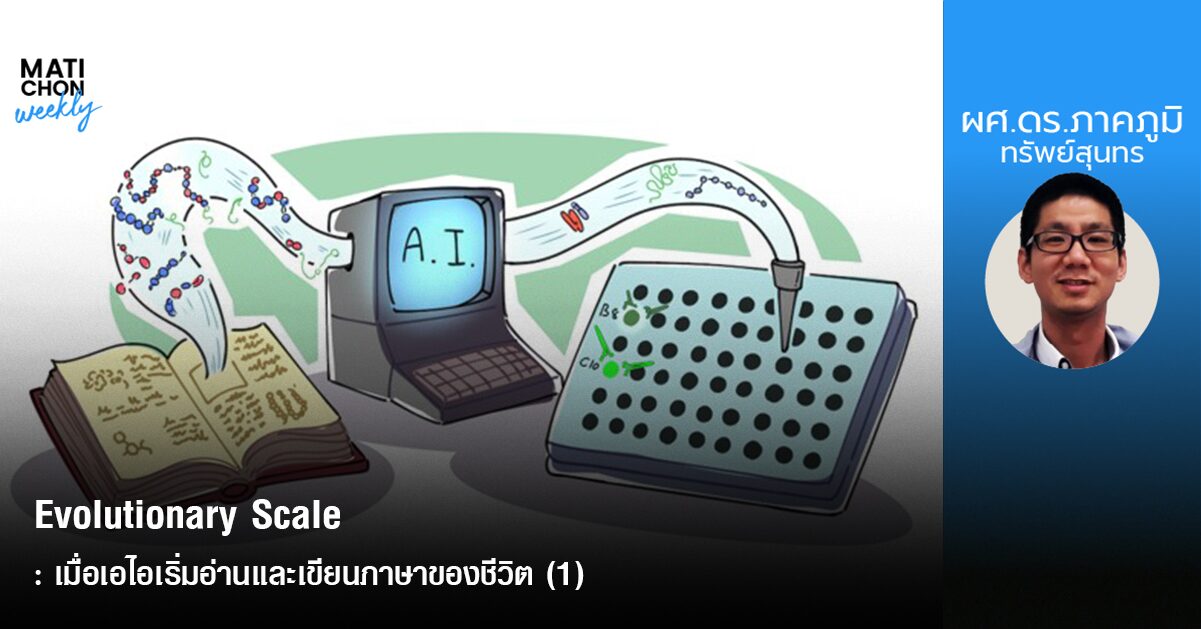
บนจานทดลอง 96 หลุม หลุม B8 เปล่งแสงสีเขียวจางๆ โปรตีนในหลุมนี้สว่างน้อยกว่าโปรตีนเรืองแสงตามธรรมชาติราว 50 เท่า และต้องใช้เวลาประมาณหนึ่งสัปดาห์กว่าจะเรืองแสงเต็มที่ แต่สำหรับทีมวิจัย ความสำเร็จไม่ได้อยู่ที่ความสว่าง
เพราะลำดับกรดอะมิโนของโปรตีนตัวนี้ไม่ได้ถูกค้นพบในสิ่งมีชีวิต คอมพิวเตอร์เป็นผู้เสนอให้สร้างขึ้นมา
ทีมวิจัยใช้ B8 เป็นจุดตั้งต้นให้เอไอออกแบบโปรตีนอีก 96 แบบ คราวนี้หลุม C10 ให้โปรตีนที่สว่างใกล้เคียงกับธรรมชาติ พวกเขาเรียกมันว่า esmGFP โปรตีนยาว 229 กรดอะมิโนที่ต่างจากโปรตีนเรืองแสงธรรมชาติที่ใกล้เคียงที่สุดถึง 96 ตำแหน่ง บริษัทเปรียบเทียบความห่างนี้กับสายวิวัฒนาการที่แยกกันนานกว่า 500 ล้านปี
ไม่ใช่ว่าเอไอจำลองวิวัฒนาการจริงๆ นานขนาดนั้น
แต่ผลทดลองทำให้เกิดคำถามว่า เครื่องจักรเรียนรู้วิธีเขียนโปรตีนใหม่ได้อย่างไร
Cr. Peach nom
ผู้สร้างเครื่องนี้คือทีมของ Alex Rives ซึ่งเริ่มจากห้องวิจัยเอไอของ Facebook หรือ Meta แต่ต่อมาถูกยุบทีม และต้องหาทางเดินหน้าต่อด้วยตนเอง
เรื่องของพวกเขาสะท้อนปัญหาที่ใหญ่กว่าโปรตีนสีเขียวตัวเดียว เมื่อชีววิทยาต้องอาศัยคอมพิวเตอร์มหาศาล ใครจะมีทรัพยากรสร้างเครื่องมือเหล่านี้ และใครจะตัดสินว่าควรใช้มันทำอะไร
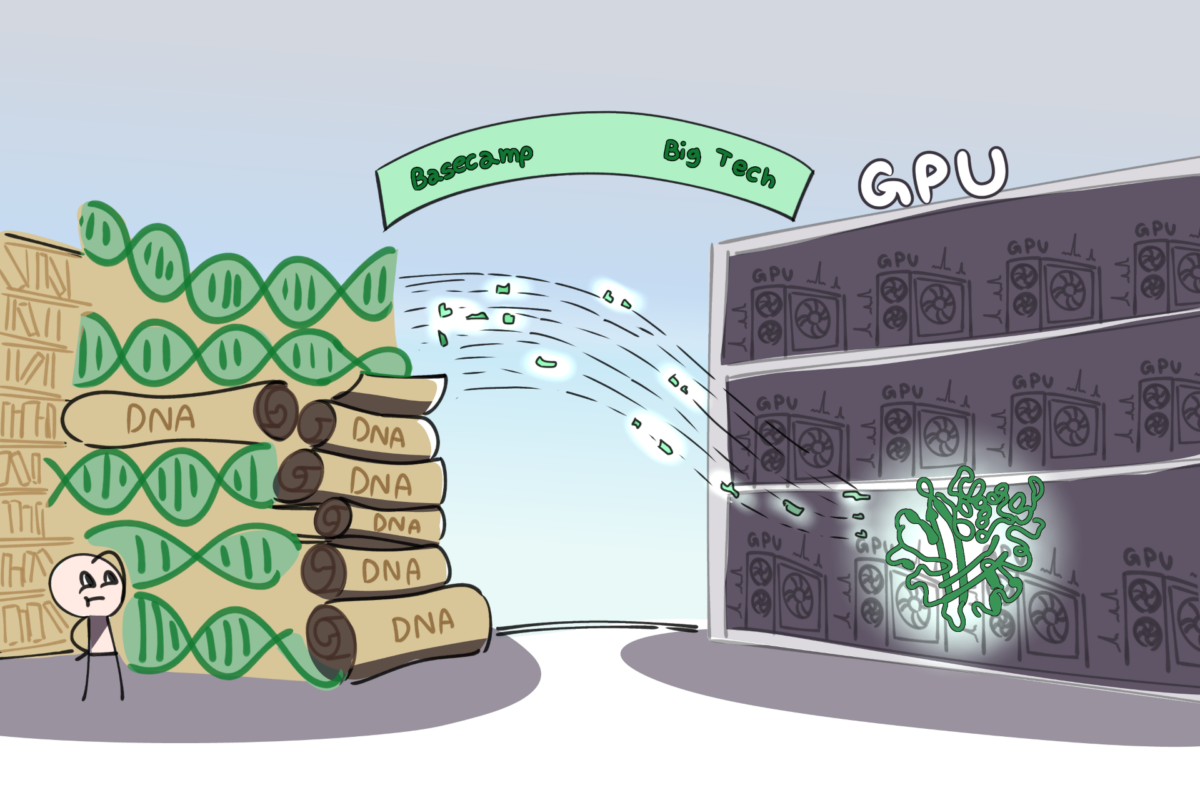
ในตอนก่อนเราเล่าถึง Basecamp บริษัทที่พยายามรวบรวมความหลากหลายของข้อมูลพันธุกรรมราวกับสร้างห้องสมุดแห่งชีวิต แต่มีหนังสือมากไม่ได้แปลว่าเราอ่านออกทั้งหมด ลำดับดีเอ็นเอและโปรตีนเพิ่มขึ้นเร็วจนการวิเคราะห์ด้วยวิธีเดิมไม่ทัน บริษัทเทคโนโลยีขนาดใหญ่ (Big Tech) จึงเข้ามามีบทบาทสำคัญ เพราะมีทั้งนักวิจัยเอไอ วิศวกรซอฟต์แวร์ และระบบประมวลผลขนาดใหญ่
ตัวอย่างที่เห็นชัดคือ AlphaFold ของ Google DeepMind ซึ่งช่วยทำนายโครงสร้างสามมิติของโปรตีน ในปี 2022 DeepMind และ EMBL-EBI เปิดฐานข้อมูลโครงสร้างที่ทำนายแล้วกว่า 200 ล้านรายการให้นักวิทยาศาสตร์ทั่วโลกใช้
แม้การทำนายไม่เท่ากับผลทดลอง แต่ขนาดของทรัพยากรนี้เปลี่ยนวิธีเริ่มต้นศึกษาปัญหาโปรตีนไปมาก
Cr. Peach nom
Rives ตั้งคำถามต่างออกไป แทนที่จะเริ่มจากการคำนวณว่าโปรตีนหนึ่งตัวควรพับอย่างไร เขาถามว่า ถ้าให้เอไออ่านลำดับกรดอะมิโนหลายร้อยล้านสายโดยไม่บอกโครงสร้างหรือหน้าที่ของแต่ละตัว มันจะค้นพบแบบแผนของโปรตีนได้เองหรือไม่
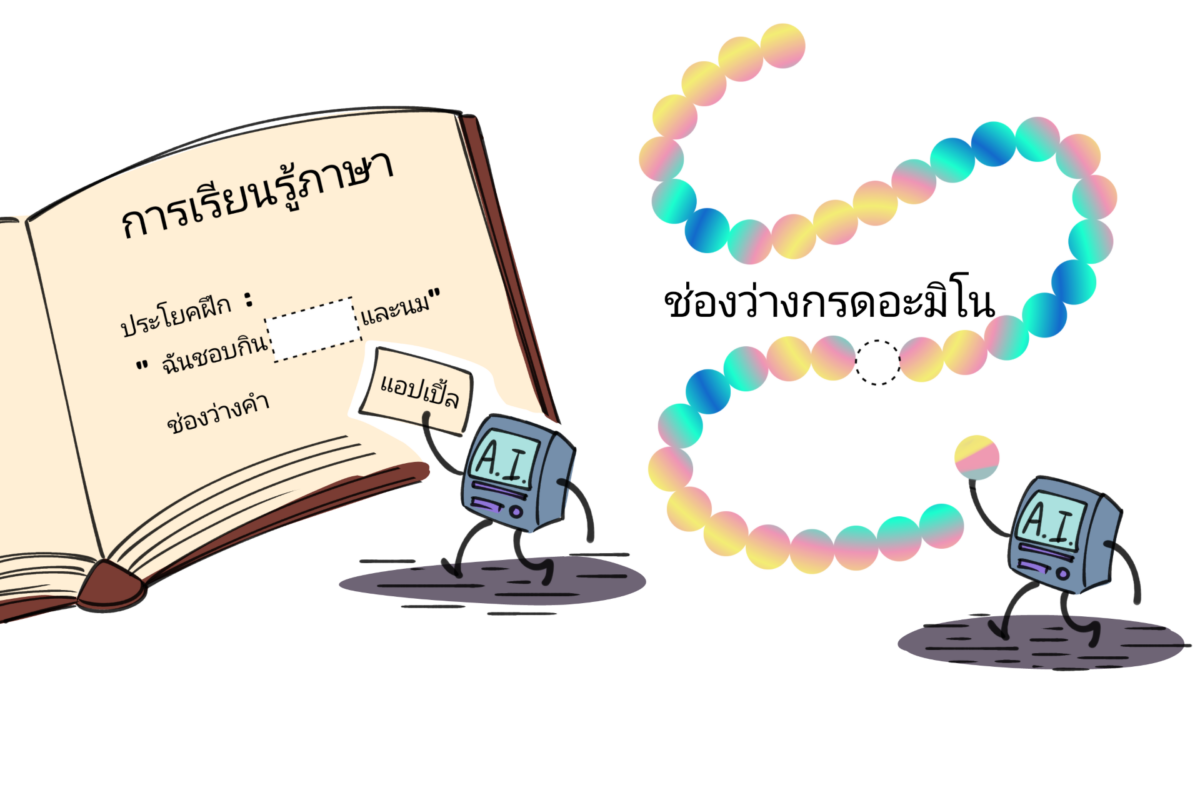
เขายืมแนวคิดจากเอไอภาษา ปิดคำบางคำในประโยค แล้วให้เครื่องเดาคำที่หายไป การเดาซ้ำๆ จากตัวอย่างมากพอทำให้เครื่องเรียนรู้ความสัมพันธ์ของคำโดยไม่ต้องมีใครสอนไวยากรณ์ทุกข้อ
โปรตีนมีกรดอะมิโนพื้นฐาน 20 ชนิด แต่การเรียงตัวไม่ได้สุ่มอย่างอิสระ ตำแหน่งที่อยู่ห่างกันอาจต้องเข้ามาสัมผัสกันเมื่อโปรตีนพับตัว และการกลายพันธุ์ตำแหน่งหนึ่งอาจต้องมีการเปลี่ยนอีกตำแหน่งมาชดเชย ลำดับที่พบในธรรมชาติจึงเก็บร่องรอยของข้อจำกัดทางฟิสิกส์และวิวัฒนาการไว้
ทีมของ Rives ฝึกระบบชื่อ Evolutionary Scale Modeling หรือ ESM ด้วยโปรตีนราว 250 ล้านลำดับ แล้วให้มันเดากรดอะมิโนที่ถูกปิดบัง
วิธีนี้เรียกว่า self-supervised learning
Cr. Peach nom
ผลจากงานที่เผยแพร่ตั้งแต่ปี 2019 และตีพิมพ์ในปี 2021 น่าสนใจตรงที่สิ่งที่เอไอเรียนรู้เพื่อเติมกรดอะมิโนกลับช่วยทำนายคุณสมบัติบางอย่างของโปรตีนได้ด้วย
เช่น ลักษณะโครงสร้างและความสัมพันธ์ระหว่างตำแหน่งในสายโปรตีน มันไม่ได้แปลว่าเครื่องเข้าใจชีววิทยาเหมือนนักวิทยาศาสตร์ แต่แสดงว่าหนังสือที่ธรรมชาติเขียนทิ้งไว้มีข้อมูลมากกว่าที่เราเคยอ่านออก
ทีมขยายแนวคิดนี้เป็น ESMFold ซึ่งทำนายโครงสร้างจากลำดับโปรตีนได้โดยตรง ในปี 2022 Meta ใช้ GPU ราว 2,000 ตัว ประมวลผลประมาณสองสัปดาห์ เพื่อทำนายโครงสร้างโปรตีนจากข้อมูลสิ่งแวดล้อมกว่า 617 ล้านลำดับ
แม้ผลบางส่วนมีความเชื่อมั่นต่ำและไม่ได้ผ่านการทดลองยืนยัน
แต่ขนาดและความเร็วของโครงการทำให้เห็นว่าพลังคำนวณระดับอุตสาหกรรมเปิดโจทย์ใหม่ให้ชีววิทยาได้อย่างไร
ผลงาน ESMFold ตีพิมพ์ใน Science เดือนมีนาคม 2023
แต่ในช่วงเวลาเดียวกัน Meta กำลังเปลี่ยนทิศทางธุรกิจ บริษัทประกาศลดพนักงานมากกว่า 11,000 คนในปลายปี 2022 และลดตำแหน่งเพิ่มเติมในปี 2023 ภายใต้นโยบาย Year of Efficiency
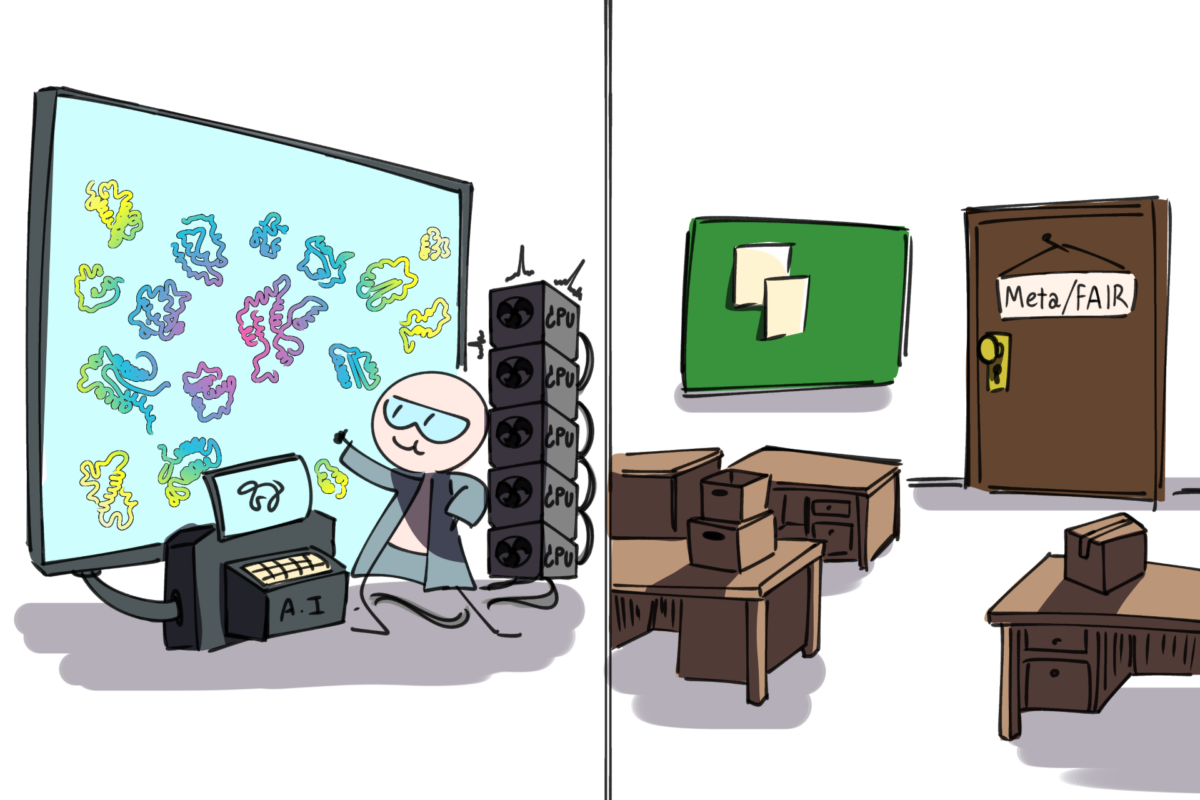
เดือนเมษายนปีนั้น ทีมวิจัยโปรตีนของ Rives ถูกยุบด้วย
แม้เราไม่รู้เหตุผลภายในที่แน่นอน แต่ความย้อนแย้งชัดเจน
บริษัทเทคโนโลยีมีเงินและคอมพิวเตอร์ที่ช่วยให้งานวิทยาศาสตร์ก้าวกระโดดได้ ขณะเดียวกัน อนาคตของงานวิจัยก็ขึ้นอยู่กับการตัดสินใจทางธุรกิจของบริษัทนั้น
เพียงไม่กี่สัปดาห์หลังงานใหญ่ตีพิมพ์ใน Science ทีมที่สร้างเครื่องอ่านภาษาของโปรตีนก็ไม่มีห้องวิจัยเดิมให้ทำงานต่อ
หากการพัฒนาเอไอชีววิทยาต้องใช้เครื่องคอมพิวเตอร์หลายพันตัว พวกเขาจะหาใครมาสนับสนุนการเดินทางต่อไป?